
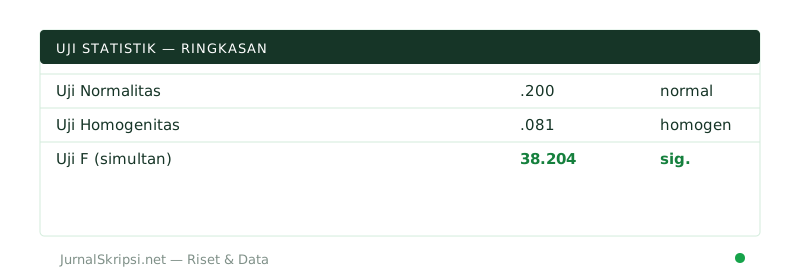
Analisis regresi adalah metode statistik yang digunakan untuk mengukur kekuatan hubungan antara dua variabel atau lebih serta memprediksi nilai variabel terikat berdasarkan variabel bebas. Metode ini sangat penting dalam penelitian ilmiah tingkat sarjana untuk menguji hipotesis pengaruh antarvariabel secara kuantitatif.
Apa Saja Jenis-Jenis Analisis Regresi dalam Statistik?
Jenis-jenis analisis regresi dalam statistik meliputi regresi linear sederhana, regresi linear berganda, dan regresi logistik yang disesuaikan dengan jenis skala data penelitian. Pemilihan jenis uji ini bergantung pada jumlah variabel independen serta karakteristik data yang dikumpulkan oleh mahasiswa.
Regresi linear sederhana digunakan ketika peneliti ingin mengetahui pengaruh satu variabel bebas terhadap satu variabel terikat. Bentuk persamaan matematisnya relatif sederhana dan mudah divisualisasikan dalam diagram pencar. Sementara itu, regresi linear berganda melibatkan lebih dari satu variabel bebas untuk menjelaskan variasi pada satu variabel terikat, yang jauh lebih sering digunakan dalam penelitian skripsi ilmu sosial dan ekonomi.
Selain data kontinu, terdapat pula regresi logistik yang digunakan ketika variabel terikatnya bersifat biner atau kategorikal, seperti kategori ya atau tidak, lulus atau tidak lulus. Pemahaman mendalam mengenai karakteristik data ini akan menghindarkan mahasiswa dari kesalahan pemilihan alat uji statistik yang fatal saat menyusun laporan penelitian akhir mereka.
Bagaimana Langkah-Langkah Melakukan Uji Regresi yang Benar?
Langkah-langkah melakukan uji regresi yang benar mencakup pengumpulan data, pengujian asumsi klasik, estimasi model, dan interpretasi koefisien determinasi. Setiap tahapan harus dilalui secara sistematis agar hasil analisis yang diperoleh valid dan dapat dipertanggungjawabkan secara akademis.
| Tahapan Uji | Tujuan Utama | Kriteria Keberhasilan |
|---|---|---|
| 1. Uji Normalitas | Memastikan data berdistribusi normal | Nilai signifikansi > 0,05 |
| 2. Uji Multikolinearitas | Mendeteksi korelasi antarvariabel bebas | Tolerance > 0,10 dan VIF < 10 |
| 3. Uji Heteroskedastisitas | Menguji kesamaan varians residual | Nilai signifikansi > 0,05 |
| 4. Uji Hipotesis (t & F) | Menguji pengaruh parsial dan simultan | Nilai p-value < 0,05 |
Tahap pertama dimulai dengan memastikan bahwa data primer atau sekunder yang telah dikumpulkan melalui kuesioner atau studi pustaka sudah bersih dari pencilan ekstrem. Setelah data siap, peneliti memasukkan data tersebut ke dalam software statistik seperti SPSS atau Stata untuk memulai proses komputasi angka.
Sebelum membaca nilai koefisien regresi, mahasiswa wajib melakukan uji asumsi klasik terlebih dahulu khususnya pada model regresi berganda berbasis OLS atau Ordinary Least Squares, yaitu metode estimasi regresi linier untuk meminimalkan jumlah kuadrat residual. Jika asumsi seperti normalitas dan bebas multikolinearitas terpenuhi, barulah hasil analisis dapat diinterpretasikan dengan aman tanpa bias.
Bagaimana Cara Membaca dan Menginterpretasikan Hasil Regresi?
Cara membaca dan menginterpretasikan hasil regresi dilakukan dengan melihat nilai koefisien regresi b, nilai t hitung dibandingkan t tabel, serta nilai R-squared untuk mengetahui persentase sumbangan pengaruh. Interpretasi yang akurat akan menjawab rumusan masalah penelitian secara presisi.
Sebagai contoh konkret dalam skripsi pemasaran, jika peneliti ingin mengetahui pengaruh kualitas produk (X1) dan harga (X2) terhadap kepuasan pelanggan (Y), software statistik akan mengeluarkan persamaan regresi Y = a + b1X1 + b2X2. Nilai b1 menunjukkan besarnya perubahan pada kepuasan pelanggan setiap kali kualitas produk mengalami kenaikan satu satuan, dengan asumsi variabel harga dianggap konstan atau tetap.
Selain melihat koefisien arah, mahasiswa juga harus memperhatikan nilai signifikansi atau p-value pada tabel Coefficients. Jika nilai signifikansinya berada di bawah taraf nyata alpha 5 persen atau 0,05, maka hipotesis alternatif diterima yang berarti terdapat pengaruh yang signifikan secara statistik. Sebaliknya, jika nilai signifikansinya di atas 0,05, maka pengaruh tersebut dinilai tidak signifikan meskipun angka koefisiennya terlihat besar.
Mengapa Uji Asumsi Klasik Sangat Penting Sebelum Regresi?
Uji asumsi klasik sangat penting sebelum melakukan interpretasi regresi guna menjamin model yang terbentuk bersifat BLUE atau Best Linear Unbiased Estimator. Tanpa pemenuhan asumsi dasar ini, kesimpulan yang ditarik dari hasil olah data skripsi bisa menjadi menyesatkan dan tidak valid.
Beberapa masalah umum yang sering ditemukan mahasiswa meliputi adanya gejala heteroskedastisitas, di mana varian dari residual tidak konstan dari satu pengamatan ke pengamatan lainnya. Jika masalah ini terjadi, peneliti harus melakukan transformasi data atau menggunakan metode estimasi robust agar standar error yang dihasilkan tetap akurat dan dapat diandalkan.
Selain itu, masalah autokorelasi sering muncul pada data time series atau runtut waktu, di mana kesalahan pengganggu pada periode tertentu berkorelasi dengan kesalahan pengganggu pada periode sebelumnya. Pemahaman terhadap seluruh kendala teknis ini akan membuat sidang skripsi berjalan jauh lebih lancar karena mahasiswa mampu menjawab sanggahan dosen penguji dengan argumen statistik yang sangat kokoh.
Pertanyaan Umum
Apa perbedaan utama antara regresi linear sederhana dan berganda?
Perbedaan utamanya terletak pada jumlah variabel independen atau variabel bebas yang diteliti. Regresi linear sederhana hanya melibatkan satu variabel bebas dan satu variabel terikat, sedangkan regresi linear berganda melibatkan dua atau lebih variabel bebas untuk memprediksi satu variabel terikat.
Bagaimana cara mengatasi masalah multikolinearitas pada data skripsi?
Masalah multikolinearitas dapat diatasi dengan mengeluarkan salah satu variabel bebas yang memiliki korelasi sangat tinggi dengan variabel lainnya, menambah jumlah sampel penelitian, atau melakukan transformasi data. Peneliti harus memeriksa nilai VIF di bawah 10 sebelum melanjutkan analisis.
Apa yang dimaksud dengan koefisien determinasi atau R-squared?
Koefisien determinasi adalah metrik statistik yang menunjukkan seberapa besar persentase variasi dari variabel terikat yang dapat dijelaskan oleh variabel bebas dalam model. Nilai R-squared berkisar antara 0 sampai 1, di mana semakin tinggi nilainya maka semakin baik kemampuan model tersebut dalam menjelaskan data.
Penguasaan terhadap teknik pengolahan data ini tentu memerlukan ketelitian tinggi serta pemahaman konsep yang matang agar terhindar dari kesalahan penarikan kesimpulan. Apabila Anda mengalami kendala teknis seputar pengolahan angka, interpretasi output software, atau penyusunan bab hasil penelitian, manfaatkan layanan profesional dari jasa analisis data penelitian untuk mendampingi penyelesaian skripsi Anda secara tepat waktu.