
Kesalahan umum saat pakai regresi SPSS dalam pengolahan data skripsi meliputi pelanggaran asumsi klasik, interpretasi nilai koefisien determinasi R-Square yang keliru, pengabaian uji multikolinearitas, hingga salah membaca nilai signifikansi p-value pada tabel ANOVA atau Coefficients.
Apa Saja Penyebab Utama Gagalnya Uji Asumsi Klasik pada Regresi SPSS?
Penyebab utama gagalnya uji asumsi klasik adalah karakteristik data primer dari kuesioner yang tidak normal atau mengandung bias responden. Uji asumsi klasik adalah serangkaian pengujian statistik untuk memastikan model regresi bebas dari masalah asumsi dasar.
Mahasiswa sering kali langsung melakukan analisis regresi linear berganda tanpa membersihkan data outlier atau data pencilan terlebih dahulu. Akibatnya, nilai residual berdistribusi tidak normal. Solusinya, lakukan transformasi data atau hapus data ekstrem yang menyimpang jauh dari rata-rata sampel penelitian.
Mengapa Terjadi Masalah Multikolinearitas dalam Analisis Regresi SPSS?
Masalah multikolinearitas terjadi karena adanya korelasi linear yang tinggi antar variabel independen di dalam satu model regresi. Multikolinearitas adalah kondisi ketika dua atau lebih variabel bebas saling memengaruhi secara kuat sehingga mengaburkan pengaruh murni terhadap variabel terikat.
Indikator utama masalah ini pada output SPSS adalah nilai Variance Inflation Factor atau VIF yang lebih dari 10 dan nilai Tolerance di bawah 0,1. Cara mengatasinya adalah dengan mengeluarkan salah satu variabel bebas yang memiliki korelasi sangat mirip atau menggabungkan indikator kuesioner tersebut.
Bagaimana Cara Membaca Nilai R-Square dan Signifikansi dengan Benar?
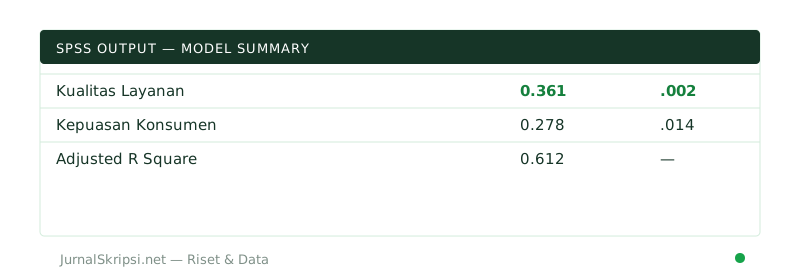
Membaca nilai R-Square atau koefisien determinasi yang tepat dilakukan dengan melihat angka Adjusted R Square untuk model regresi dengan lebih dari dua variabel independen. Nilai ini menunjukkan seberapa besar persentase variasi variabel dependen mampu dijelaskan oleh variabel independen.
Kesalahan fatal yang sering dilakukan peneliti pemula adalah menyamakan signifikansi statistik dengan signifikansi praktis. Sebuah pengaruh bisa bernilai signifikan secara statistik karena ukuran sampel yang sangat besar, meskipun pengaruh praktisnya di lapangan sebenarnya sangat kecil atau lemah.
| Tahapan Analisis | Kesalahan Umum Mahasiswa | Kriteria Valid/Solusi Tepat |
|---|---|---|
| Uji Normalitas | Mengabaikan nilai Asymp. Sig. di bawah 0,05 | Nilai signifikansi harus di atas 0,05 (Kolmogorov-Smirnov) |
| Uji Heteroskedastisitas | Hanya melihat grafik scatterplot secara subjektif | Gunakan uji Glejser dengan nilai signifikansi di atas 0,05 |
| Uji Hipotesis | Salah membaca nilai t hitung dan t tabel | Bandingkan p-value (Sig.) dengan taraf nyata alpha 0,05 |
Apa Dampak Mengabaikan Uji Autokorelasi pada Data Time Series?
Mengabaikan uji autokorelasi pada data deret waktu atau time series akan menghasilkan estimasi parameter regresi yang tidak efisien dan standar error yang terlalu kecil. Autokorelasi adalah korelasi antara anggota serangkaian observasi yang diurutkan menurut waktu atau ruang.
Dalam software SPSS, pengujian ini biasanya melibatkan nilai Durbin-Watson. Jika nilai Durbin-Watson berada di luar batas toleransi atau menunjukkan angka di bawah batas bawah tabel DW, maka model regresi Anda terjangkit autokorelasi yang wajib disembuhkan sebelum menarik kesimpulan penelitian.
Bagaimana Prosedur Mengatasi Nilai Signifikansi yang Tidak Signifikan?
Prosedur mengatasi variabel yang tidak signifikan adalah mengevaluasi kembali instrumen penelitian, memperbesar jumlah sampel, atau memperbaiki model teoretis. Peneliti tidak boleh menghapus variabel bebas secara sembarangan hanya demi mendapatkan nilai signifikansi p-value di bawah 0,05.
Tindakan manipulasi data atau membuang sampel valid secara sengaja merupakan pelanggaran etika akademik yang berat. Jika hasil hipotesis ditolak, jelaskan temuan tersebut secara objektif pada bab pembahasan skripsi dengan argumen teoretis yang kuat dan relevan.
Pertanyaan Umum
Kenapa nilai F hitung di SPSS signifikan tetapi t hitung tidak ada yang signifikan?
Kondisi ini terjadi karena adanya multikolinearitas tinggi atau ukuran sampel yang sangat kecil sehingga variabel secara bersama-sama berpengaruh tetapi secara parsial kehilangan kekuatan ujinya.
Bagaimana cara mengatasi data regresi yang tidak berdistribusi normal di SPSS?
Data yang tidak normal dapat diatasi dengan melakukan transformasi matematis seperti transformasi logaritma natural, akar kuadrat, atau menggunakan metode bootstrapping jika asumsi parametrik tetap tidak terpenuhi.
Berapa batas minimal sampel yang baik untuk uji regresi linear berganda?
Batas minimal sampel yang umum digunakan dalam penelitian kuantitatif adalah 30 responden, namun idealnya mengikuti rumus jumlah variabel dikali 10 hingga 15 responden agar hasil analisis lebih stabil.
Menghindari berbagai kesalahan teknis di atas akan membuat hasil pengolahan data skripsi Anda jauh lebih kredibel di hadapan dosen penguji. Jika Anda mengalami kendala pelik terkait pengolahan angka, manfaatkan layanan profesional jasa uji asumsi klasik dari jurnalskripsi.net untuk memastikan hasil analisis Anda valid seratus persen.