
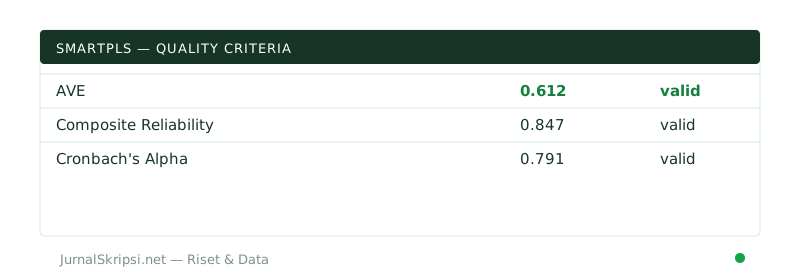
Kesalahan umum saat pakai SmartPLS meliputi kegagalan memahami spesifikasi model pengukuran, pengabaian uji normalitas data sekunder, kesalahan interpretasi nilai *Outer Loading*, serta tidak melaporkan nilai *Collinearity Statistics* (VIF) yang berakibat pada bias hasil estimasi dalam analisis SEM-PLS.
Mengapa Kesalahan Penggunaan SmartPLS Sering Terjadi pada Mahasiswa?
Kesalahan penggunaan SmartPLS sering terjadi karena mahasiswa sering kali langsung mengolah data tanpa memahami asumsi dasar Partial Least Squares Structural Equation Modeling atau metode PLS-SEM yang merupakan teknik analisis berbasis varian untuk menguji hubungan kompleks antar variabel.
Ketidaktahuan terhadap prosedur pengujian bertahap membuat banyak peneliti pemula langsung melompat ke tahap *bootstrapping* tanpa memastikan kualitas model luar atau *outer model* mereka sudah memenuhi standar yang dipersyaratkan oleh literatur metodologi riset modern.
Apa Saja Kesalahan Umum Saat Pakai SmartPLS pada Model Pengukuran?
Kesalahan umum saat pakai SmartPLS pada tahap model pengukuran adalah mempertahankan indikator dengan nilai *outer loading* di bawah batas minimum yang disarankan tanpa melakukan analisis mendalam terlebih dahulu terkait validitas konvergen.
Dalam praktiknya, indikator dengan nilai muatan luar di bawah 0,70 sering kali harus dieliminasi. Namun, jika nilainya berada di antara 0,40 hingga 0,70, peneliti harus mempertimbangkan dampaknya terhadap peningkatan *Average Variance Extracted* atau AVE dan reliabilitas komposit sebelum menghapusnya dari kuesioner penelitian.
Bagaimana Kesalahan Penilaian Validitas Diskriminan Terjadi?
Kesalahan penilaian validitas diskriminan terjadi ketika peneliti hanya mengandalkan kriteria *Fornell-Larcker* dan mengabaikan pendekatan *Heterotrait-Monotrait Ratio* atau HTMT yang jauh lebih akurat dalam mendeteksi masalah validitas diskriminan pada model berbasis kovarians maupun varian.
Nilai rasio HTMT yang melebihi ambang batas 0,90 mengindikasikan adanya masalah kurangnya validitas diskriminan yang serius antar konstruk, yang berarti dua variabel laten yang berbeda sebenarnya dinilai oleh responden sebagai konsep yang sangat mirip atau bahkan sama persis.
Mengapa Nilai Kolinearitas VIF Sering Diabaikan?
Nilai kolinearitas VIF atau *Variance Inflation Factor* sering diabaikan karena mahasiswa biasanya hanya fokus pada nilai koefisien jalur dan nilai R-square saja tanpa memeriksa apakah terjadi multikolinearitas antar variabel prediktor dalam struktur model dalam.
Jika nilai VIF pada setiap kombinasi variabel laten menunjukkan angka di atas 5, maka model tersebut mengalami masalah kolinearitas tinggi yang dapat mendistorsi bobot estimasi regresi dan menghasilkan kesimpulan pengujian hipotesis yang menyesatkan.
Bagaimana Cara Menghindari Kesalahan Pengujian Hipotesis dengan Bootstrapping?
Cara menghindari kesalahan pengujian hipotesis adalah dengan memastikan jumlah *samples* pada menu *bootstrapping* diatur minimal 5000 kali dan menggunakan opsi *complete bootstrapping* agar distribusi sampel ulang menghasilkan nilai t-statistik yang stabil dan akurat.
Banyak peneliti pemula keliru menggunakan sampel *bootstrapping* bawaan yang sering kali hanya berjumlah 500 kali, padahal standar publikasi jurnal internasional dan pedoman sidang skripsi terkini mewajibkan minimal 5000 sub-sampel untuk mencapai tingkat konvergensi hasil yang optimal.
Tabel Panduan Evaluasi Model SmartPLS
Berikut adalah tabel tahapan evaluasi model yang harus diperhatikan untuk menghindari kesalahan fatal saat mengoperasikan perangkat lunak statistik ini:
| Tahapan Evaluasi | Parameter Utama | Nilai Ambang Batas Ideal |
|---|---|---|
| Outer Model (Reflektif) | Outer Loading | > 0.70 (atau > 0.40 jika AVE memenuhi) |
| Validitas Konvergen | Average Variance Extracted (AVE) | > 0.50 untuk setiap variabel laten |
| Reliabilitas Komposit | Composite Reliability | > 0.70 (lebih baik jika > 0.80) |
| Validitas Diskriminan | Heterotrait-Monotrait Ratio (HTMT) | < 0.90 (ideal di bawah 0.85) |
| Inner Model | R-Square (R2) | 0.75 (kuat), 0.50 (moderat), 0.25 (lemah) |
| Kolinearitas | Variance Inflation Factor (VIF) | < 5.0 (bebas dari multikolinearitas) |
Bagaimana Mengatasi Kesalahan Pengisian Data Hilang?
Kesalahan pengisian data hilang atau *missing values* sering diatasi secara sembarangan oleh mahasiswa dengan menghapus baris responden secara langsung, yang justru mengurangi jumlah sampel minimum yang dibutuhkan untuk mengestimasi model persamaan struktural.
Langkah yang benar adalah menggunakan fitur *mean replacement* atau algoritma *median* yang tersedia di dalam sistem perangkat lunak untuk mengisi nilai kosong tersebut tanpa harus membuang data kuesioner berharga yang sudah dikumpulkan dengan susah payah di lapangan.
Pertanyaan Umum
Berapa jumlah sampel minimum saat menggunakan SmartPLS?
Jumlah sampel minimum umumnya mengikuti aturan 10 kali dari jumlah jalur terbesar yang mengarah ke suatu konstruk dalam model struktural, atau minimal 30 hingga 100 responden tergantung pada kompleksitas model penelitian Anda.
Apa bedanya model reflektif dan formatif di SmartPLS?
Model reflektif berasumsi bahwa indikator disebabkan oleh variabel laten, sedangkan model formatif berasumsi bahwa indikator-indikator tersebut justru membentuk atau menyebabkan variabel laten itu sendiri terjadi.
Bagaimana cara mengatasi nilai R-square yang terlalu rendah?
Nilai R-square yang rendah dapat diatasi dengan menambahkan variabel mediasi atau moderasi yang relevan secara teoretis, serta memperbaiki kualitas instrumen kuesioner agar mampu menangkap fenomena riset dengan lebih akurat.
Memahami berbagai kendala teknis di atas akan menyelamatkan penelitian Anda dari revisi beruntun saat sidang skripsi berlangsung. Jika Anda masih mengalami kendala pelik dalam proses pengolahan data penelitian, manfaatkan layanan profesional jasa analisis SmartPLS dari jurnalskripsi.net untuk hasil yang valid, cepat, dan terpercaya.