
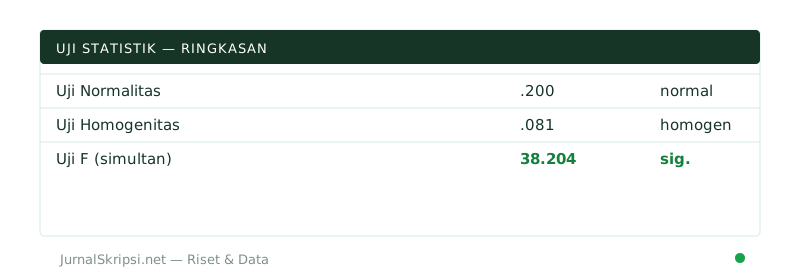
Tips statistik skripsi cepat dan akurat berpusat pada pemilihan uji hipotesis yang selaras dengan skala data, pembersihan data mentah dari nilai anomali, serta pemahaman praktis dalam membaca hasil output perangkat lunak. Mahasiswa sering kali mengalami hambatan terbesar pada bab pengolahan data karena kurangnya persiapan sistematis sejak awal penyusunan proposal penelitian.
Bagaimana Cara Menentukan Uji Hipotesis yang Tepat dan Efisien?
Cara memilih uji statistik yang tepat adalah dengan mencocokkan skala pengukuran variabel dengan rumusan masalah serta jumlah kelompok sampel yang diuji. Kesalahan pada tahap ini akan memaksa Anda mengulang analisis dari nol dan membuang waktu pengerjaan skripsi.
Mencocokkan Skala Data Penelitian
Skala data terbagi menjadi empat jenis utama yaitu nominal, ordinal, interval, dan rasio. Uji parametrik (seperti regresi linear) wajib menggunakan data interval atau rasio yang memenuhi asumsi normalitas. Sebaliknya, uji non-parametrik (seperti Mann-Whitney) dipakai untuk data ordinal atau nominal yang tidak berdistribusi normal. Memahami karakteristik ini sejak awal mencegah Anda menggunakan rumus yang keliru.
Menyesuaikan Jumlah Variabel dan Sampel
Jumlah variabel independen dan dependen menentukan kompleksitas rumus matematika yang dipakai. Sebagai contoh, jika Anda membandingkan rata-rata dua kelompok sampel bebas, gunakan Independent Sample t-Test. Jika kelompok yang dibandingkan lebih dari dua, gunakan Analysis of Variance (ANOVA), yaitu metode statistika inferensial untuk menguji perbedaan rata-rata antara tiga kelompok atau lebih.
Matriks Pemilihan Uji Statistik Berdasarkan Tujuan Penelitian
Tabel berikut merangkum panduan cepat untuk mencocokkan tujuan analisis dengan jenis uji yang relevan:
| Tujuan Penelitian | Skala Data | Rekomendasi Uji Statistik |
|---|---|---|
| Mengetahui pengaruh variabel X terhadap Y | Interval / Rasio | Regresi Linear Berganda |
| Membandingkan dua kelompok independen | Interval / Rasio (Normal) | Independent Sample t-Test |
| Melihat hubungan antarvariabel kategori | Nominal / Ordinal | Uji Chi-Square (Chi-Kuadrat) |
Apa Saja Tahapan Membersihkan Data Penelitian agar Akurat?
Tahapan membersihkan data penelitian agar akurat meliputi deteksi missing value, eliminasi data pencilan, serta pengujian asumsi klasik secara berurutan. Data kuesioner mentah hampir selalu memerlukan proses penyaringan sebelum dimasukkan ke dalam model analisis.
Mengatasi Missing Value dan Data Kosong
Missing value adalah kondisi di mana terdapat data atau sel jawaban responden yang kosong akibat kuesioner tidak diisi lengkap. Anda dapat mengatasi hal ini dengan metode penghapusan baris (listwise deletion) jika jumlahnya sedikit, atau melakukan imputasi nilai rata-rata (mean imputation) agar ukuran sampel tetap ideal tanpa merusak representasi populasi.
Mendeteksi Data Pencilan atau Outlier
Outlier adalah nilai pengamatan yang muncul dengan nilai ekstrim sangat jauh atau berbeda dari rata-rata kelompok data lainnya. Nilai ekstrem ini dapat mendistorsi hasil koefisien regresi secara signifikan. Anda dapat mendeteksi outlier menggunakan grafik boxplot atau melihat nilai z-score standar yang melebihi angka 3,0.
Melakukan Uji Asumsi Klasik untuk Data Regresi
Model regresi linear berganda mensyaratkan terpenuhinya beberapa uji asumsi agar hasil estimasi bersifat Best Linear Unbiased Estimator (BLUE). Pengujian ini mencakup uji normalitas residual, uji multikolinearitas (melihat nilai Tolerance dan VIF), uji heteroskedastisitas, serta uji autokorelasi khusus untuk data deret waktu (time series).
Software Apa yang Paling Efisien untuk Olah Data Skripsi?
Software yang paling efisien untuk olah data skripsi adalah aplikasi yang disesuaikan dengan tingkat kerumitan model penelitian serta latar belakang kemampuan teknis mahasiswa. Memilih alat bantu yang tepat akan memangkas durasi komputasi secara signifikan.
Memanfaatkan SPSS untuk Analisis Standar
SPSS (Statistical Package for the Social Sciences) adalah program komputer pengolah data statistik yang sangat ramah bagi pemula karena menggunakan antarmuka berbasis menu grafis (GUI). Software ini sangat handal untuk uji deskriptif, regresi linear, maupun uji beda tanpa mengharuskan mahasiswa menulis baris kode pemrograman.
Menggunakan SmartPLS untuk Model Kompleks
SmartPLS adalah perangkat lunak berbasis Structural Equation Modeling (SEM) dengan pendekatan Partial Least Squares untuk menguji hubungan antarvariabel laten yang rumit secara simultan. Software ini bekerja sangat optimal meskipun ukuran sampel penelitian relatif kecil dan data tidak berdistribusi normal.
Bagaimana Contoh Kasus Konkret Analisis Statistik Skripsi?
Sebagai contoh kasus konkret, seorang mahasiswa bernama Budi meneliti pengaruh Motivasi Belajar ($X_1$) dan Fasilitas Kampus ($X_2$) terhadap Indeks Prestasi Kumulatif ($Y$) dengan sampel sebanyak 100 responden mahasiswa ekonomi.
Eksekusi Model dan Pembacaan Angka
Budi memasukkan data kuesioner ke dalam software pengolah angka, lalu menjalankan menu regresi linear berganda. Berdasarkan teori dari Sugiyono mengenai uji pengaruh, Budi mendapati nilai signifikansi (p-value) untuk variabel Motivasi Belajar sebesar 0,003 dan Fasilitas Kampus sebesar 0,042.
Menarik Kesimpulan Penelitian
Karena kedua nilai signifikansi tersebut berada di bawah taraf nyata alpha 0,05, Budi menyimpulkan bahwa hipotesis alternatif diterima. Artinya, secara parsial terdapat pengaruh yang signifikan antara motivasi belajar dan fasilitas kampus terhadap indeks prestasi mahasiswa. Arah koefisien regresi bernilai positif, yang berarti semakin baik motivasi dan fasilitas, maka IPK cenderung semakin meningkat.
Bagaimana Kesalahan Umum yang Sering Terjadi dan Solusinya?
Kesalahan umum dalam pengolahan data skripsi sering kali bersumber dari ketidaktelitian teknis saat mentransfer data kuesioner ke dalam lembar kerja digital.
Salah Memberi Kode Variabel dan Skala
Banyak mahasiswa keliru memasukkan skala data ordinal dari kuesioner skala Likert ke dalam format nominal di software statistik, sehingga rumus uji parametrik menjadi tidak valid. Solusinya, selalu periksa tabulasi data di Excel dan pastikan kolom variabel diatur sebagai scale atau numeric sebelum diimpor ke aplikasi pengolah statistik.
Panik Melihat Output Angka yang Terlalu Banyak
Lembar hasil output software sering kali mencetak puluhan halaman tabel yang membingungkan. Solusinya, abaikan angka yang tidak berkaitan dengan rumusan masalah Anda; fokuslah hanya pada tabel model summary, ANOVA, dan coefficients utama.
Pertanyaan Umum
Berapa jumlah sampel minimal agar uji statistik skripsi valid?
Jumlah sampel minimal umumnya adalah 30 responden untuk memenuhi asumsi normalitas dasar, namun untuk analisis regresi berganda atau SEM disarankan minimal 100 responden atau mengikuti rumus 5 hingga 10 kali jumlah indikator total penelitian.
Bagaimana jika data skripsi saya tidak berdistribusi normal?
Jika data tidak berdistribusi normal, Anda dapat mencoba melakukan transformasi data menggunakan fungsi logaritma natural, atau beralih menggunakan metode uji non-parametrik yang tidak memerlukan asumsi kenormalan data.
Apakah boleh menggunakan jasa analisis data untuk skripsi?
Menggunakan jasa Analisis Data diperbolehkan asalkan mahasiswa tetap aktif memahami proses teoretis, logika pemilihan rumus, serta cara membaca output agar mampu mempertanggungjawabkan hasil penelitian saat sidang skripsi.